

MiniMax ha distribuito MiniMax M3.1 Flash il 19 ottobre 2026 con un listino di 0,15 dollari per milione di token in ingresso e 0,60 dollari per milione in uscita. Il modello è disponibile attraverso i servizi dell’azienda, mentre i pesi saranno pubblicati successivamente. La novità interessa chi costruisce agenti e software: il prezzo unitario scende, ma il costo di un compito dipende anche da quanto il sistema ragiona, dagli strumenti che usa e dalle correzioni necessarie.
Il listino dimezza due tariffe, non ogni fattura
La pagina ufficiale dei prezzi permette un confronto preciso. Nella fascia standard fino a 512.000 token in ingresso, MiniMax M3 costa 0,30 dollari per milione in ingresso e 1,20 dollari in uscita. Flash dimezza entrambe le tariffe. La lettura della cache passa da 0,06 a 0,015 dollari per milione. Sono voci di fatturazione differenti: il prezzo della cache si applica ai token effettivamente riconosciuti come riutilizzabili, non a tutto il materiale inviato.
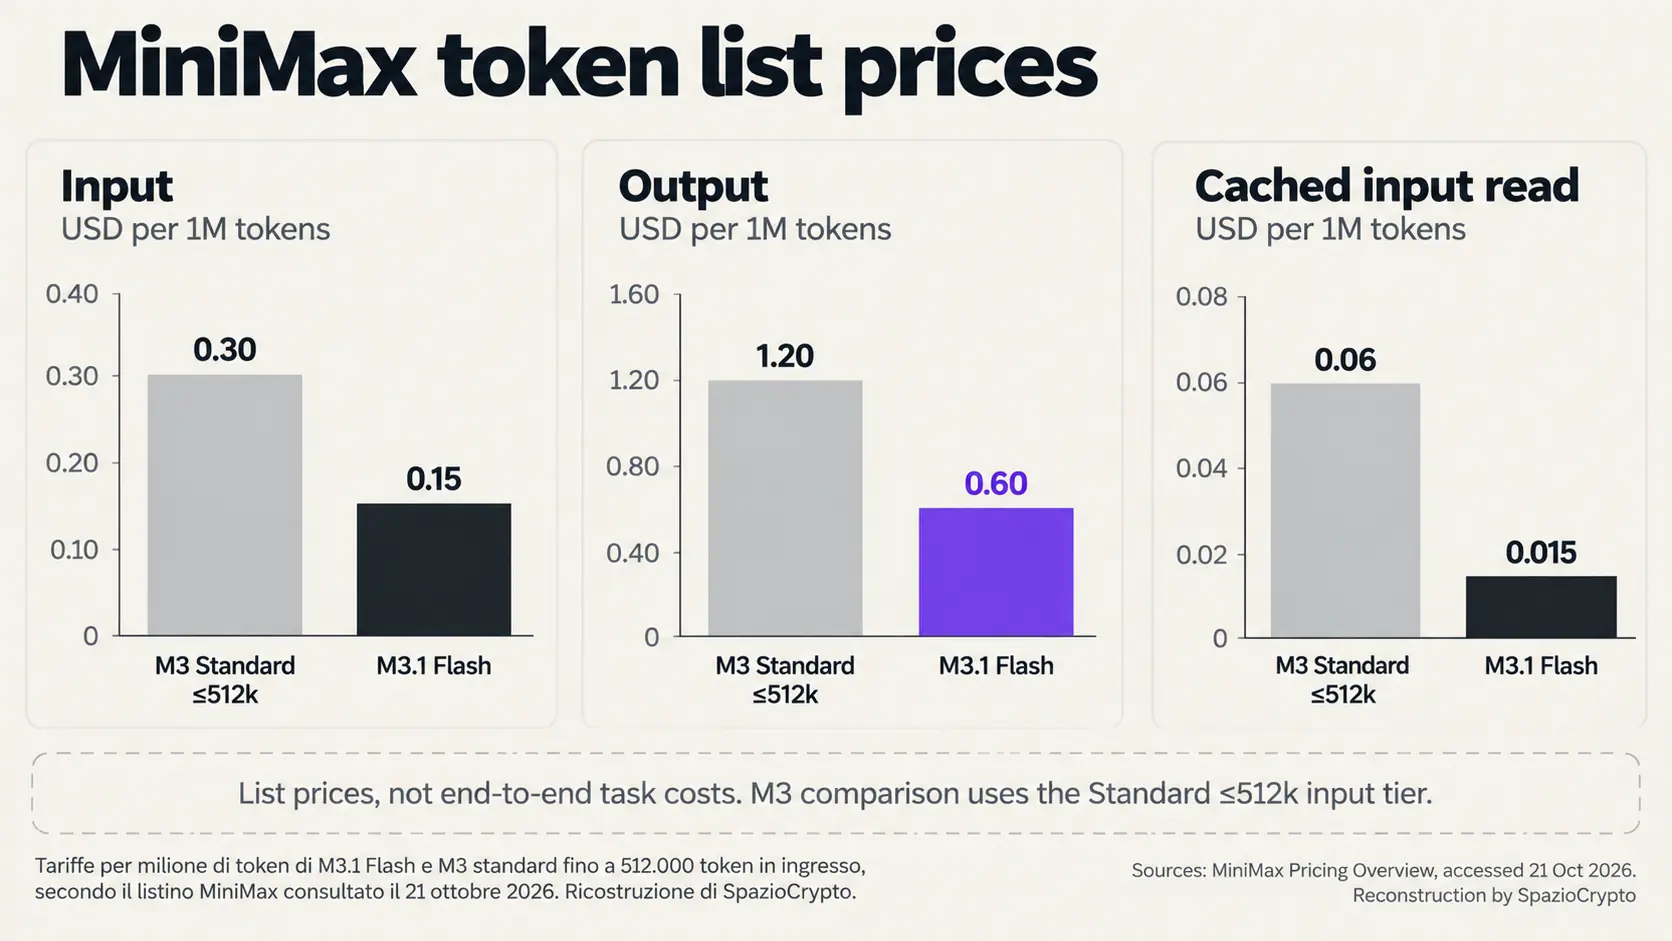
Il comunicato parla di un costo complessivo dei compiti agentici inferiore del 70% rispetto al predecessore. Il dato non coincide con il dimezzamento delle due tariffe principali. Può includere differenze nel consumo e nel modo di completare il lavoro, ma non autorizza a promettere quel risparmio a ogni cliente. Nel seguire l’adozione di sistemi automatizzati, questa distinzione separa un listino verificabile da un risultato operativo ancora da misurare sul proprio carico.
Un esempio chiarisce la differenza. Un milione di token in ingresso, distribuiti fra richieste entro la fascia indicata, e 100.000 in uscita, senza cache, costerebbero 0,21 dollari con Flash e 0,42 con M3 nella fascia indicata. È un calcolo nostro e indicativo, costruito sullo stesso consumo ipotetico. Non comprende chiamate aggiuntive, strumenti o lavoro umano. Se un agente ripete un passaggio o produce più ragionamento, la quantità fatturata cambia anche quando il prezzo unitario resta identico.
Il ragionamento ha una regolazione, non uno spegnimento
La documentazione dell’interfaccia compatibile con Anthropic descrive cinque livelli di ragionamento, da low a max. Per M3.1 Flash, max è il valore predefinito quando il parametro viene omesso. Il ragionamento adattivo non può essere disabilitato con i valori indicati per spegnerlo: la documentazione segnala un errore per quella richiesta. Un’integrazione che riutilizza configurazioni precedenti deve quindi controllare il comportamento effettivamente supportato dal nuovo modello.
Secondo le stesse istruzioni, aumentare il livello può produrre più token di ragionamento e maggiore latenza. Il prezzo di ciascun token e il tempo complessivo della risposta descrivono quindi due aspetti diversi. La nostra lettura è che una prova utile debba mantenere costanti obiettivo, strumenti e criteri di accettazione, annotando il livello scelto. Altrimenti si rischia di confrontare una risposta veloce con un lavoro più approfondito senza esplicitare il motivo della differenza.
MiniMax M3.1 Flash: Space Performance + Bunny Speed 🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash. 💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed. API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens. Model weights will arrive on Oct 23. API: https://t.co/fHRdSV73Hr M Plan: https://t.co/XfJWSyauda MiniMax Code for desktop: https://t.co/SGmLTI2HQm
— MiniMax (official) (@MiniMax_AI) October 19, 2026
Il catalogo ufficiale indica una finestra di contesto da un milione di token e capacità multimodali. La capienza dichiarata non garantisce che ogni documento lungo venga utilizzato correttamente. Per chi integra il modello tramite un’interfaccia API, il punto è conservare le informazioni necessarie fra un passaggio e il successivo. Una richiesta molto ampia può contenere istruzioni superflue o contraddittorie: poterla accettare non dimostra che il modello sappia sempre selezionare il materiale giusto.
I benchmark restano prove circoscritte
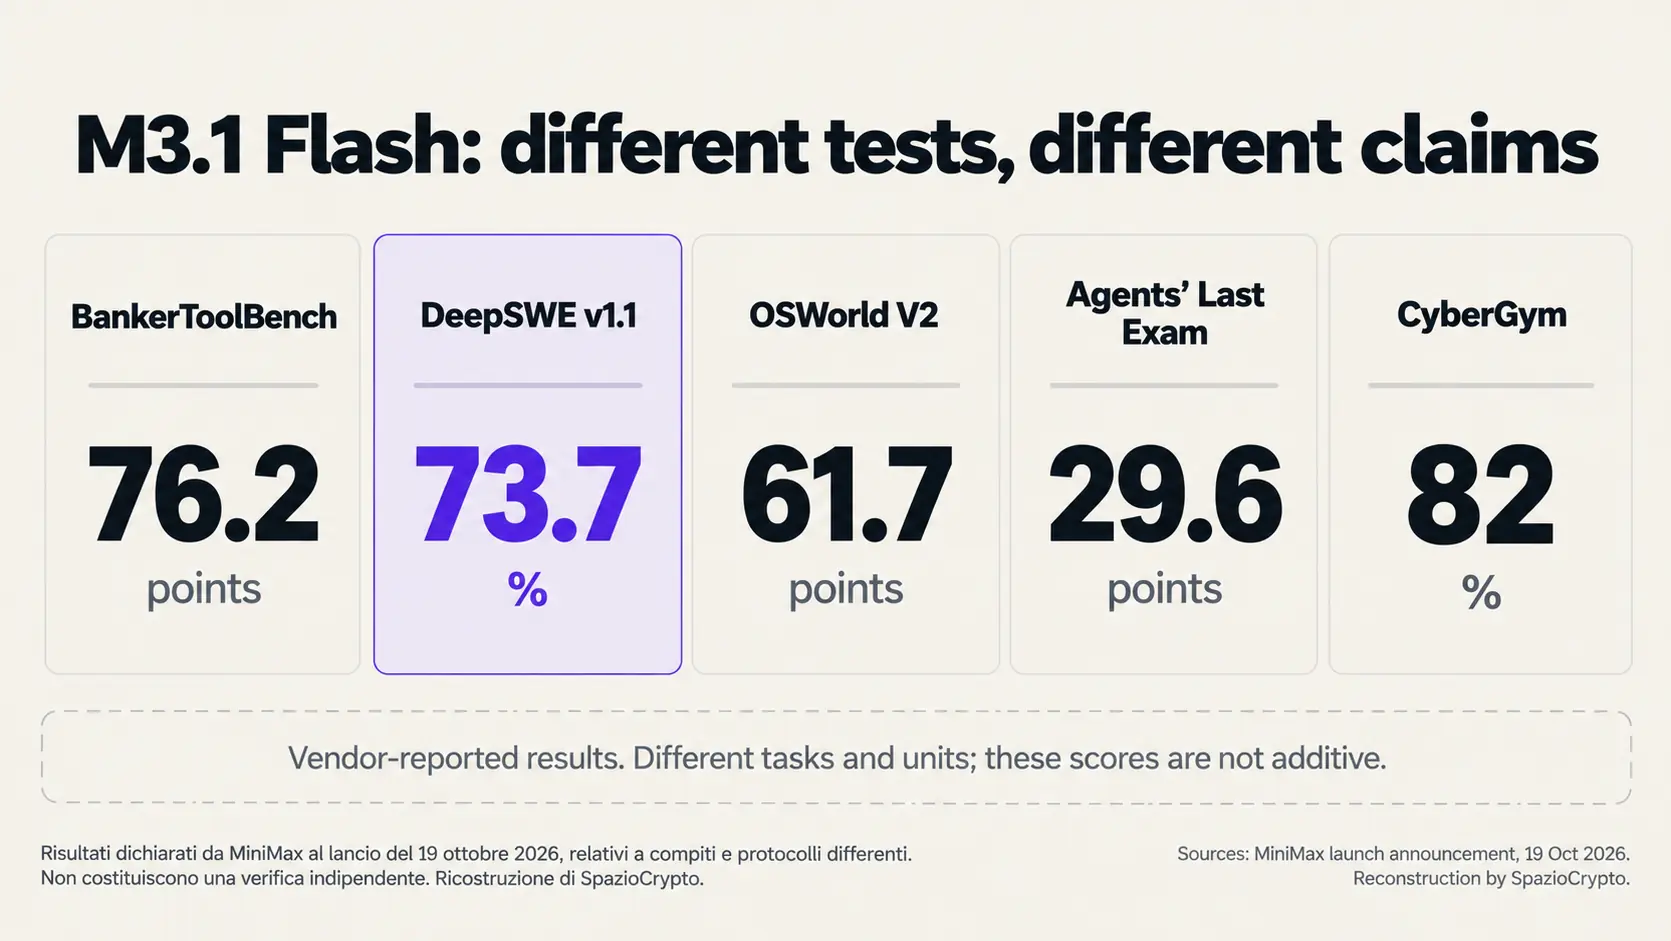
MiniMax pubblica risultati su programmazione, uso del computer e sicurezza. Tra quelli indicati nel comunicato figurano 73,7% su DeepSWE v1.1, 61,7 punti su OSWorld V2 e 82% su CyberGym. Sono risultati presentati dal produttore. Il comunicato riporta anche 76,2 punti su BankerToolBench e 29,6 su Agents’ Last Exam. I test osservano compiti differenti e non possono essere sommati per costruire una percentuale generale di affidabilità. Un buon risultato su problemi di codice non dimostra da solo che un agente gestisca senza errori documenti o permessi finanziari.
Anche le velocità richiedono un’etichetta. L’azienda dichiara oltre 200 token al secondo in alcune condizioni e una mediana superiore a 170. Sono dati della sua infrastruttura, non una garanzia sul tempo necessario a completare ogni procedura. Il numero di token generati al secondo non include automaticamente tutte le attese fra una chiamata e l’altra, le risposte di servizi esterni e l’intervento di chi controlla il risultato.
La distinzione conta anche nei confronti fra benchmark dei modelli. Un numero va accompagnato dalla versione del test, dagli strumenti consentiti e dalla configurazione di ragionamento. La nostra lettura è che per Flash servano confronti con un obiettivo identico e un budget dichiarato. Presentare una capacità di trovare vulnerabilità come prova di affidabilità generale del modello confonderebbe il compito osservato con tutte le altre attività che potrebbe svolgere.
Artificial Analysis offre un riscontro esterno su un’altra suite: nel suo post dedicato assegna a Flash 42 punti nell’Intelligence Index, con ragionamento al massimo. Riporta circa 0,22 dollari per compito dell’indice contro circa 0,51 per M3. È una valutazione pubblicata da un soggetto diverso dal produttore, non una nostra replica. Quel costo riguarda i compiti e il metodo del suo indice: non è il prezzo universale di qualsiasi lavoro affidato al modello.
Accesso al servizio e controllo dei pesi sono fasi diverse
Il rilascio del 19 ottobre indica tre canali: API MiniMax, M Plan e MiniMax Code. Il comunicato rinvia i pesi a un momento successivo senza una data; un post della pagina ufficiale MiniMax su LinkedIn indica invece il 23 ottobre. È una scadenza annunciata, non una pubblicazione già avvenuta. Il servizio utilizzabile e l’artefatto da scaricare restano quindi due fasi distinte. L’identificazione di Space Bunny come versione iniziale del modello è una dichiarazione di MiniMax; il nome anonimo non costituisce una valutazione indipendente.
MiniMax-M3.1-Flash scores 42 on the Artificial Analysis Intelligence Index, 13 points higher than MiniMax-M3 and less than half the cost per task. It scores level with GLM-5.3-Flash but behind DeepSeek V4.1 Flash 1017
— Artificial Analysis (@ArtificialAnlys) October 19, 2026
MiniMax-M3.1-Flash is @MiniMax_AI's new Flash reasoning… pic.twitter.com/bEelNegMKP
La nostra lettura è che le due modalità consentano verifiche differenti. Un servizio ospitato permette di provare subito l’interfaccia e il comportamento delle risposte. La pubblicazione dei pesi aprirebbe la possibilità di conservare l’artefatto e studiare altre configurazioni, secondo la licenza che lo accompagnerà. Il comunicato non basta a descrivere quella licenza o l’hardware necessario. Fino alla pubblicazione, attribuire a Flash una disponibilità autonoma già completa anticiperebbe un passaggio ancora promesso.
Il conto utile è quello del compito completato
Nel passaggio dal coding assistito a quello agentico, il costo si distribuisce fra più tentativi. Un agente può leggere un repository, proporre una modifica, eseguire prove e tornare sul codice quando un controllo fallisce. È un esempio operativo nostro, non un risultato misurato su Flash. Il confronto economico dovrebbe contare l’intera sequenza fino all’accettazione del lavoro, comprese le esecuzioni che non arrivano a una soluzione utilizzabile.
Il valore di una valutazione indipendente dipende anche da quanto quelle sequenze sono osservabili e riproducibili. La nostra proposta è registrare esito, consumo, ripetizioni e correzioni, mantenendo identico il criterio con cui si accetta il risultato. Abbassare il livello di ragionamento può ridurre una singola attesa e aumentare le revisioni successive. È un’ipotesi da verificare sul carico scelto, non un comportamento che attribuiamo al modello senza averlo misurato.
MiniMax M3.1 Flash in sintesi
- Confermato: rilascio del 19 ottobre, listino pubblico e documentazione dell’accesso ospitato.
- Non ancora verificato: rilascio effettivo dei pesi annunciati su LinkedIn per il 23 ottobre e risparmio su ogni processo.
- Da seguire: consumo a parità di compito, correzioni richieste e disponibilità degli artefatti promessi.
La lettura più grande
La nostra lettura è che la competizione nell’intelligenza artificiale applicata si stia spostando dal prezzo della risposta al costo del lavoro accettabile. Il listino di Flash abbassa una componente misurabile; non elimina la necessità di verificare il risultato. Un modello conveniente diventa utile quando riduce anche i passaggi che richiedono correzioni, a parità di risultato richiesto e di condizioni di esecuzione.
I prossimi segnali concreti saranno il rispetto della scadenza annunciata per i pesi, confronti riproducibili con configurazioni esplicite e misure su compiti rappresentativi. Occorre osservare anche cosa succede quando il sistema non riesce: se segnala il limite, interrompe il lavoro o continua a spendere. Sono differenze che una tariffa per milione di token non può raccontare, ma che determinano il costo finale di un agente affidabile.