
Google DeepMind ha presentato il 27 ottobre Genie 4, un modello che genera ambienti esplorabili in tempo reale con suoni, musica e dialoghi prodotti insieme alle immagini. L'utente si muove con tastiera e mouse e può cambiare la scena mentre la simulazione è in corsa, scrivendo in linguaggio naturale. Oggi lo usa un gruppo ristretto di tester selezionati. Per gli abbonati Google AI Ultra in Project Genie e per i partner delle API l'accesso è annunciato come «in arrivo», senza date. E la stessa DeepMind mette nero su bianco che oggetti, coerenza e fisica possono ancora cedere.
Abbiamo letto l'annuncio di DeepMind, firmato da Raia Hadsell, Diego Rivas e Hang Qi, il post sul blog di Google e la pagina del modello. Non abbiamo potuto aprire direttamente il post su X né riprodurre la demo su YouTube: il testo del post è riscontrato tramite l'embed pubblicato da AI Lately. Le specifiche di Genie 3 vengono dalla copertura di The Decoder dell'agosto 2025.
This is Genie 4, our most realistic and interactive world model yet. 🌐
— Google DeepMind (@GoogleDeepMind) October 27, 2026
Explore dynamic environments in real time to see how the scene responds, sounds, and how the people in it move, react, and speak. pic.twitter.com/6mmSUm9BBO
Che cosa fa
Genie 4 è un modello del mondo: non produce un filmato da guardare, ma un ambiente che risponde ai comandi fotogramma dopo fotogramma. Si parte da un testo o da un'immagine di riferimento usata come primo fotogramma. Poi si esplora con i comandi da tastiera per movimento e telecamera. Durante la sessione si può cambiare il meteo, spostare l'inquadratura, aggiungere persone o oggetti. Secondo DeepMind, un modello Gemini adatta ogni richiesta alla scena e fa procedere il mondo anche tra un comando e l'altro.
Il modello attinge alla famiglia Gemini. Gemini Omni ancora le scene ad aspetto e comportamento del mondo reale, mentre altri modelli Gemini gestiscono il ragionamento che tiene coerente la simulazione. È la stessa famiglia che Google sta spingendo nel lavoro d'ufficio con il Gemini agent per le aziende, anch'esso in anteprima riservata.
Il salto dichiarato: l'audio
DeepMind presenta Genie 4 come il primo modello del mondo in tempo reale capace di generare audio in modo nativo. Ogni ambiente ha i propri suoni di sfondo e musica. I personaggi parlano e il dialogo si adatta a comandi ed eventi.
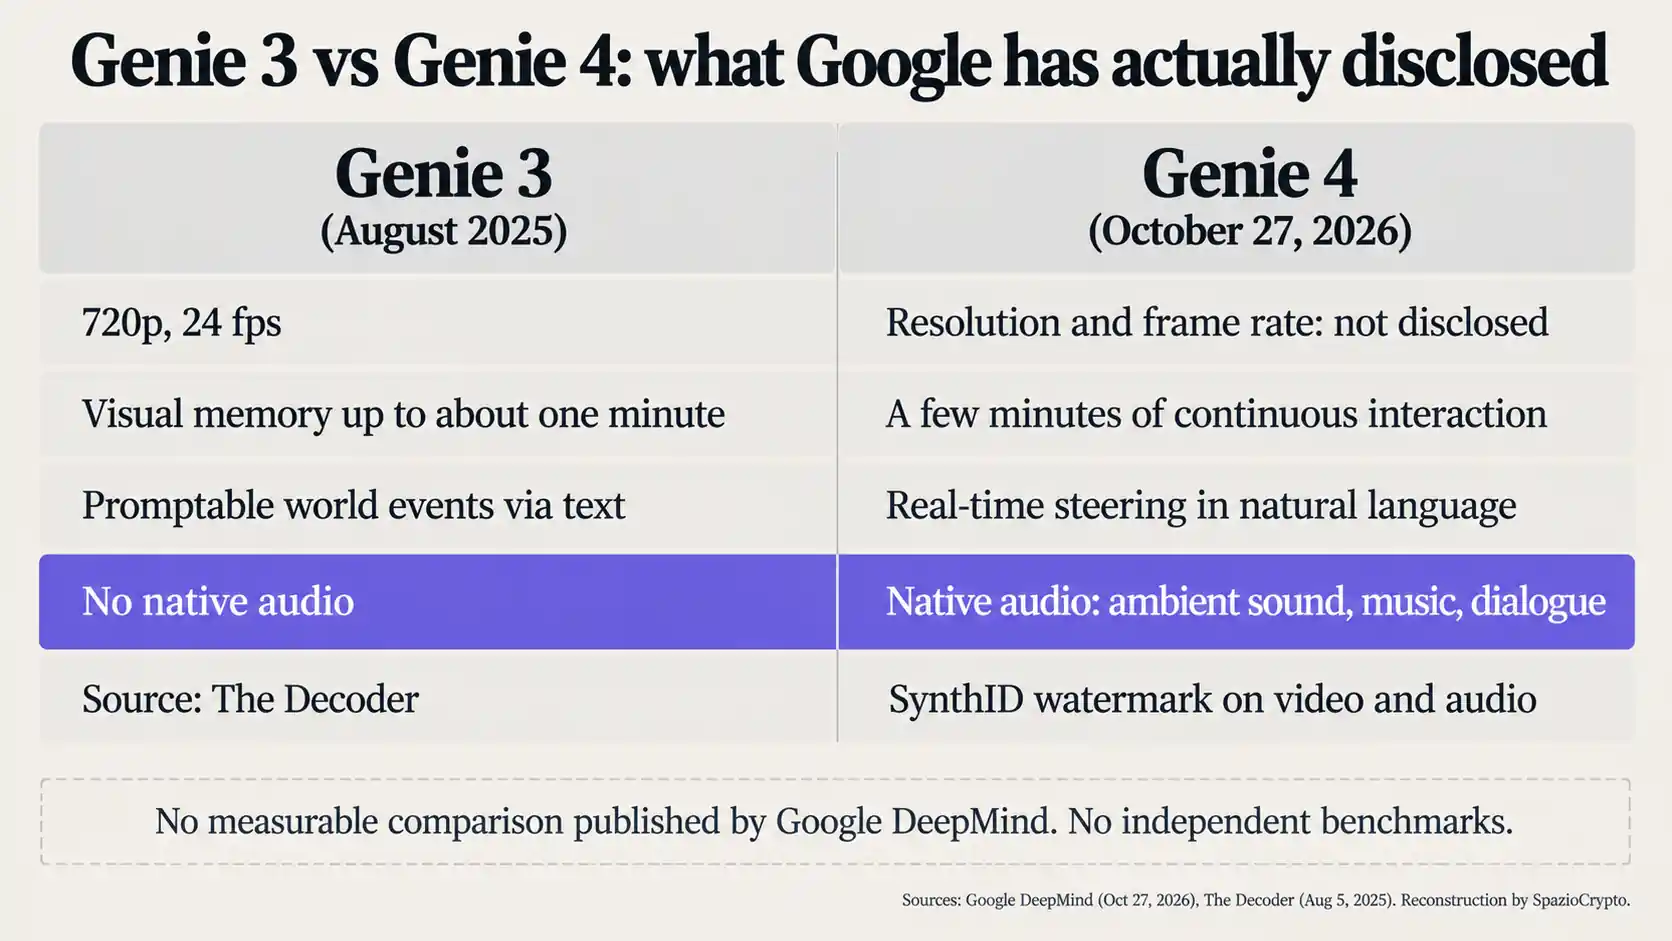
È qui la differenza con Genie 3, annunciato nell'agosto 2025. Secondo The Decoder, quel modello generava mondi a 720p e 24 fotogrammi al secondo, con una memoria visiva fino a un minuto e cambi di scena via testo, chiamati promptable world events. L'audio non c'era. Per Genie 4, DeepMind non pubblica né risoluzione né fotogrammi al secondo, né una durata in minuti, e non offre alcun confronto misurabile con la versione precedente. La pagina del modello parla solo di «pochi minuti di interazione continua» (traduzione nostra).
Prototipo interattivo, non video
La distinzione conta per capire a cosa serve. Un generatore video produce una clip chiusa. Genie 4 produce una scena che reagisce a chi la guida. DeepMind elenca usi concreti: anteprime per registi che possono girare più ciak in una simulazione dal vivo, fotogiornalisti che provano a trasformare una singola foto d'archivio in un ambiente, sviluppatori che testano stili visivi e meccaniche di gioco a partire da un testo, partner aziendali che valutano la generazione rapida di scenari. Sono flussi che si sommano agli strumenti già in uso tra i creator, come quelli che Adobe e NVIDIA stanno accelerando.
Il terreno più strategico è la simulazione per agenti e robot. Nell'annuncio, Gemini 3.8 Flash osserva i fotogrammi, divide un obiettivo in passaggi, verifica ciascuno e corregge il piano quando il mondo cambia o l'utente interviene. In un'altra demo, Gemini 4 Argon lavora con Genie 4 su un compito robotico con il robot Apollo di Apptronik e una partita a dama. Allenare agenti in mondi generati è la stessa scommessa della AI fisica di NVIDIA e LG. Ma tra una demo e una linea di produzione c'è una distanza che i robot umanoidi in fabbrica mostrano bene.
I limiti, scritti da DeepMind
L'annuncio non nasconde i punti deboli. Dettagli visivi e permanenza degli oggetti possono deviare, soprattutto nelle sessioni lunghe, dopo più modifiche via testo o durante la navigazione. Restano oggetto di ricerca le interazioni fisiche complesse, l'accuratezza dell'audio in tempo reale, il testo leggibile, la precisione spaziale e la coerenza nel lungo periodo.
La pagina del modello aggiunge altri tre limiti. Il primo è l'interazione tra più agenti e più utenti nello stesso ambiente. Il secondo sono i luoghi reali, che non possono essere riprodotti con precisione. Il terzo è la durata: pochi minuti, non sessioni estese. Una nota avverte che le registrazioni mostrate sono sessioni reali ma accorciate, con risultati a scopo illustrativo. Non c'è alcun benchmark né valutazione indipendente: quello che si vede è una dimostrazione aziendale.
Chi può provarlo, e quando
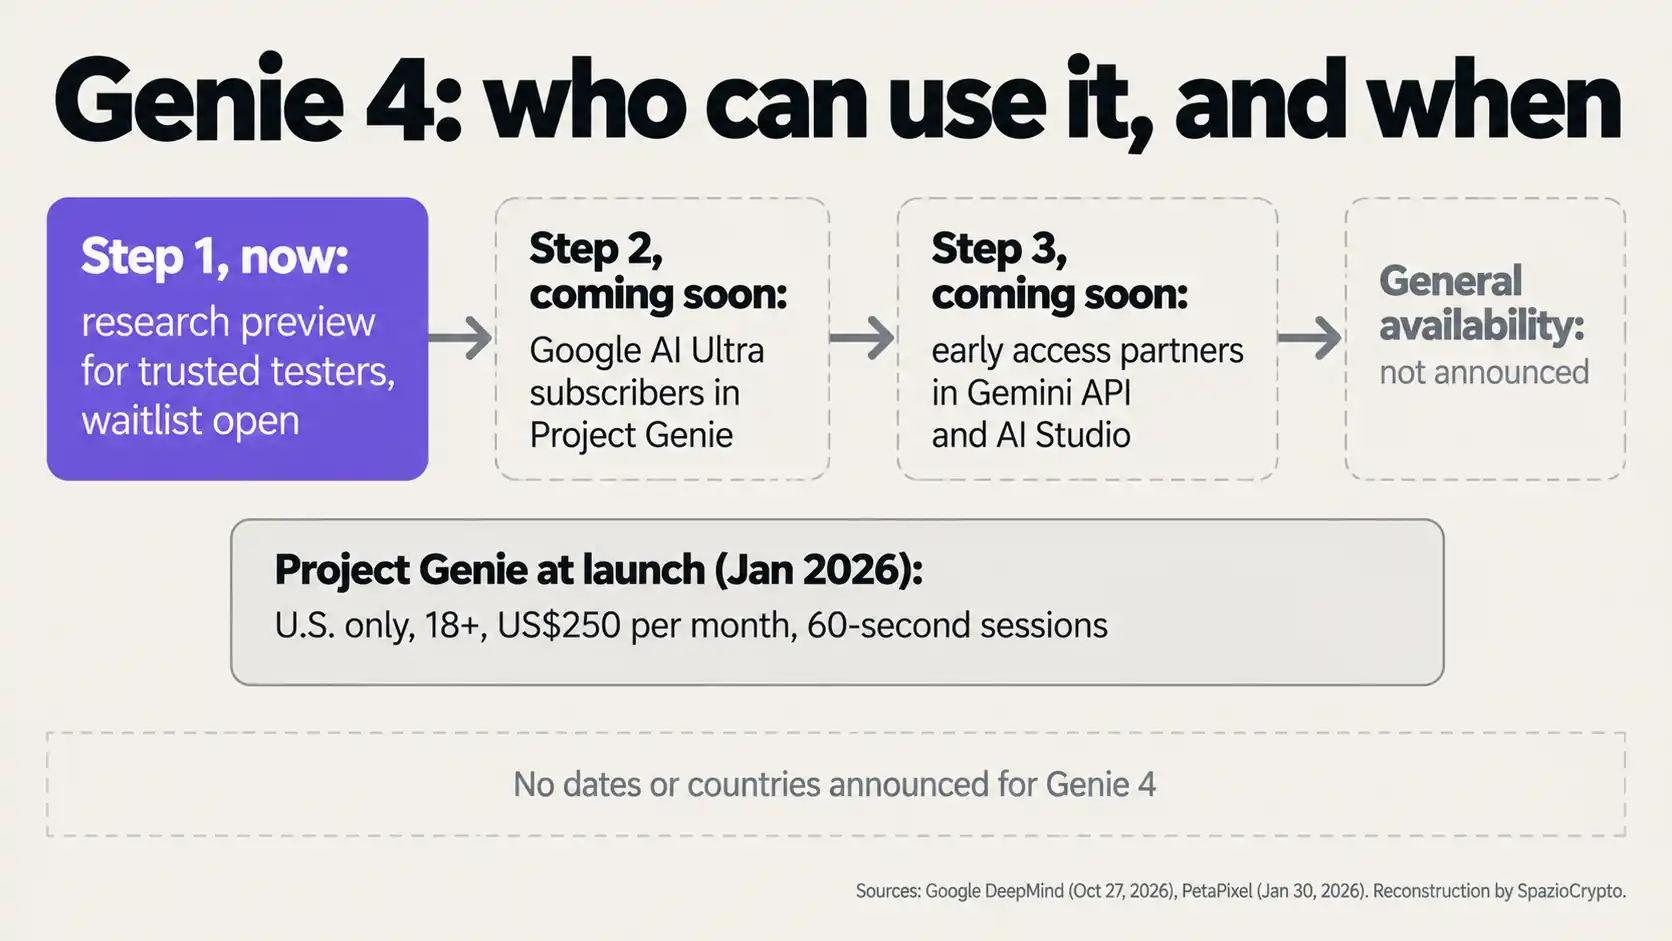
La risposta breve: quasi nessuno, per ora. Il modello è in anteprima di ricerca per tester fidati, con una lista d'attesa aperta. Poi toccherà agli abbonati Google AI Ultra dentro Project Genie, e ai partner con accesso anticipato all'API Gemini e ad AI Studio. Nessuna data, nessun Paese indicato.
Il precedente aiuta a calibrare le attese. Project Genie è nato il 29 gennaio 2026 con Genie 3 e, secondo PetaPixel, al lancio era riservato agli abbonati Ultra negli Stati Uniti, maggiorenni, a 250 dollari al mese, con generazioni limitate a 60 secondi. Non sappiamo se quel perimetro sia stato allargato. Per l'Italia, quindi, non c'è oggi un percorso di accesso confermato. Sul fronte della trasparenza, DeepMind dichiara che tutti i video e gli audio generati da Genie 4 avranno la filigrana SynthID: un tema che pesa, dopo casi come il video premiato e poi squalificato da Nikon per uso dell'AI generativa.
Genie 4 in sintesi
Cosa è confermato, cosa no
- Confermato: modello del mondo in tempo reale con audio nativo, scene modificabili via testo durante la sessione, anteprima per tester selezionati, filigrana SynthID su video e audio, limiti dichiarati su oggetti, fisica, audio e durata.
- Non indicato: risoluzione, fotogrammi al secondo, durata in minuti, Paesi e date di disponibilità, prezzi API, benchmark o valutazioni indipendenti.
- Da seguire: l'apertura agli abbonati Ultra in Project Genie e ai partner API, e le prime prove indipendenti su coerenza e fisica.
La lettura più grande
La nostra lettura, che dichiariamo come tale, è che Genie 4 sposti la gara dell'AI generativa dalla clip al mondo. Il video si guarda, l'ambiente si usa: si prova un livello di gioco, si gira una scena, si allena un agente. Per questo i limiti dichiarati pesano più che in un generatore video. Un oggetto che sparisce in una clip è un difetto estetico. In un simulatore per robot o agenti è un dato sbagliato. Il valore sta nella prototipazione rapida, non ancora nella simulazione affidabile.
I segnali da seguire sono tre. Il primo: quando e dove l'accesso si allargherà oltre i tester, e con quale durata delle sessioni. Il secondo: se arriveranno valutazioni indipendenti su permanenza degli oggetti, coerenza e fisica, oggi assenti. Il terzo: quanto l'uso con gli agenti, come quelli che operano al computer per conto degli utenti, passerà dalle demo ai flussi di lavoro reali.