Un guasto di rete ha interrotto per oltre un giorno l’accesso a Outlook, Teams, Copilot e ad altre funzioni di Microsoft 365 per utenti in diverse aree del mondo. Microsoft ha riferito che il problema è emerso dopo una modifica di rete e ha indicato progressi nel ripristino, ma al 14 novembre la pagina di stato segnalava ancora una degradazione del servizio. L’azienda ha escluso, secondo le proprie dichiarazioni, un attacco informatico e un legame con sistemi di intelligenza artificiale: la causa tecnica completa dovrà arrivare dal rapporto post incidente.
Abbiamo consultato la pagina pubblica di stato Microsoft, gli aggiornamenti dell’Associated Press e il resoconto di Sky News. AP riferisce che le segnalazioni su Downdetector hanno raggiunto livelli molto superiori alla media in 74 Paesi; si tratta di report inviati dagli utenti, non di un conteggio ufficiale delle persone colpite.
Il disservizio ha coinvolto posta, collaborazione e Copilot
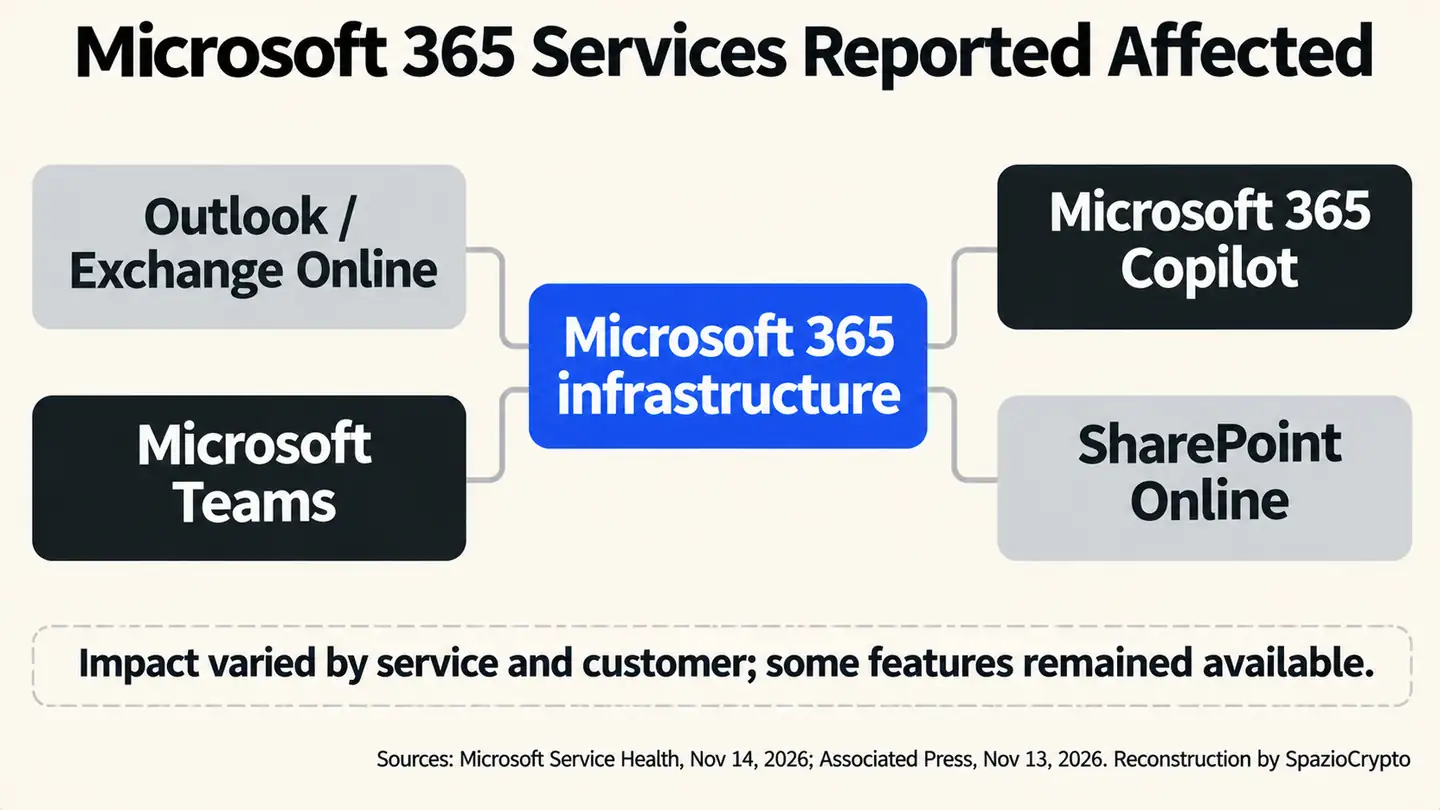
L’incidente è iniziato il 12 novembre e ha interessato più componenti di Microsoft 365. Tra i servizi citati negli aggiornamenti figurano Exchange Online e Outlook, Teams, Copilot, SharePoint e alcune funzioni di amministrazione e produttività. L’impatto non è stato identico per ogni prodotto: Microsoft ha indicato che le funzioni dipendenti dai servizi di posta e Exchange potevano essere degradate, mentre alcune capacità non collegate a tali sistemi restavano disponibili.
Per gli utenti, i problemi segnalati comprendevano difficoltà ad accedere alla casella, ritardi nella consegna delle email e interruzioni di alcune funzioni di collaborazione e assistenza AI. La pagina di stato Microsoft indicava che alcuni clienti potevano ancora incontrare accessi intermittenti o ricevere messaggi in ritardo mentre proseguivano le attività di recupero.
La propagazione tra prodotti diversi è il tratto più significativo dell’episodio. Un servizio cloud non è composto da applicazioni indipendenti: autenticazione, rete, posta, archiviazione e servizi di backend possono sostenere più strumenti allo stesso tempo. Quando un livello condiviso perde capacità o non risponde correttamente, l’effetto può apparire in prodotti che agli utenti sembrano separati.
Questo non significa che ogni servizio Microsoft sia stato indisponibile o che Azure abbia subito un’interruzione generalizzata. Il disservizio documentato ha riguardato specifiche funzioni di Microsoft 365, con impatti diversi per area e prodotto. La pagina pubblica di SpazioCrypto dedicata ai data center raccoglie le notizie sulle infrastrutture che sostengono servizi cloud e AI.
Microsoft collega il guasto a una modifica di rete
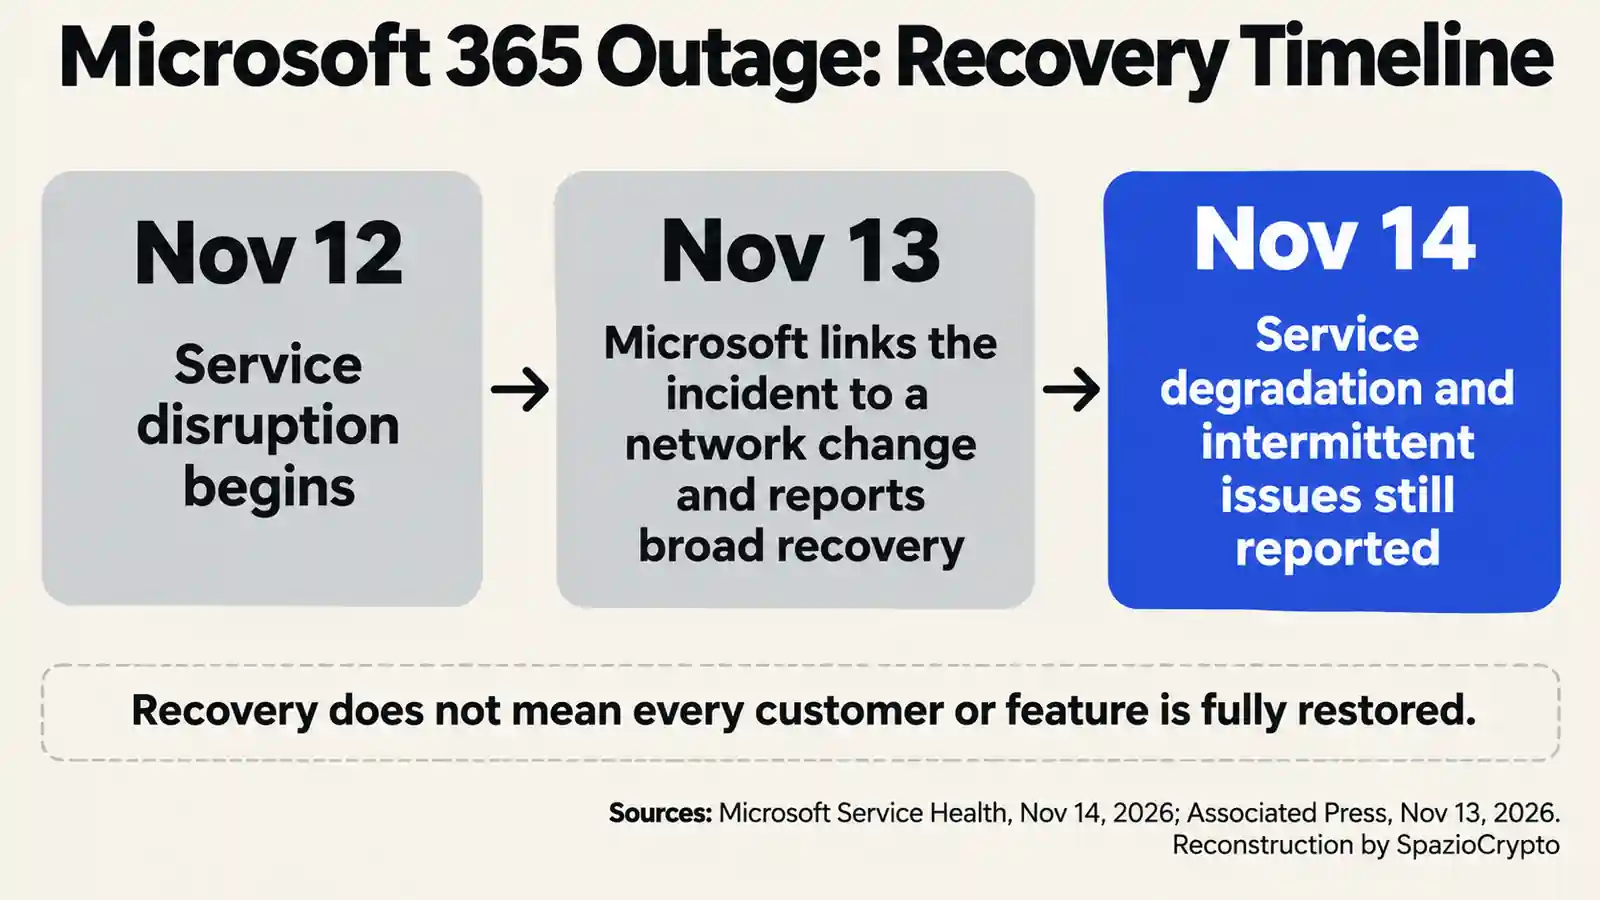
Nell’aggiornamento del 13 novembre, Microsoft ha descritto l’incidente come un problema tecnico non legato a un attacco informatico né all’AI o agli agenti. La società ha riferito che un problema durante un precedente upgrade della capacità di rete si è manifestato dopo una modifica successiva. Gli ingegneri hanno lavorato per recuperare capacità, ripristinare i sistemi coinvolti e riportare gradualmente i servizi a livelli stabili.
La formulazione pubblica chiarisce il tipo di evento, ma non equivale ancora a un’analisi tecnica completa della causa. Microsoft ha detto che pubblicherà un rapporto post incidente dopo la mitigazione, con la causa principale e le misure di prevenzione. Fino a quel momento, dettagli più specifici su configurazioni, componenti coinvolti e sequenza degli errori non vanno presentati come accertati.
Anche l’esclusione di un cyberattacco va attribuita all’azienda. Microsoft ha dichiarato di non avere evidenze di attività malevola associata al problema; questo è un aggiornamento utile, ma non sostituisce il rapporto conclusivo né una verifica indipendente. Le prime ipotesi circolate online non costituiscono prove sull’origine del guasto.
La distinzione tra un problema tecnico e un incidente di sicurezza è importante per gli utenti e per le organizzazioni. Nel primo caso il rischio principale può essere la disponibilità; nel secondo possono aggiungersi accesso non autorizzato o esposizione dei dati. Per ora le informazioni pubbliche di Microsoft indicano un problema di disponibilità e capacità, non una compromissione dei dati.
Il recupero è ampio, ma l’impatto non è ancora archiviato
AP ha riferito il 13 novembre che Microsoft osservava una ripresa estesa e una maggiore stabilità in Nord America, Europa e Asia-Pacifico. Le code email stavano tornando verso livelli normali, ma alcuni clienti potevano ancora subire accessi intermittenti e ritardi. Il 14 novembre la pagina pubblica di stato continuava a riportare una degradazione di Microsoft 365, perciò la ripresa non va confusa con la chiusura formale dell’incidente.
Le conseguenze operative hanno superato il semplice disagio individuale. AP ha raccolto segnalazioni di interruzioni presso aziende e organismi pubblici in diversi Paesi, comprese attività che dipendono dalla posta per comunicazioni e procedure. Le ricadute variano da un’organizzazione all’altra: non tutte le funzioni erano ferme e non ogni ente citato ha riportato un’interruzione critica.
Microsoft 365 conta oltre 450 milioni di abbonamenti commerciali a pagamento, secondo AP. Il dato aiuta a capire la scala potenziale di un disservizio della piattaforma, ma non indica quanti utenti siano stati effettivamente colpiti in questa occasione. L’azienda non ha pubblicato un totale verificato di account interessati.
La vicenda riporta al centro la dipendenza delle imprese da pochi fornitori di cloud e strumenti di produttività. Le autorità europee hanno già richiamato l’attenzione sui rischi legati alla concentrazione di servizi digitali e AI presso operatori esterni all’Unione, come raccontato nell’analisi sulla dipendenza della finanza europea da infrastrutture digitali straniere. Questo incidente non dimostra da solo un rischio sistemico, ma mostra perché i piani di continuità e i sistemi alternativi meritino verifiche pratiche.
La resilienza dipende anche dai piani di continuità
Un’organizzazione non può evitare ogni guasto presso un fornitore esterno, ma può ridurre l’impatto operativo. Tra le misure da verificare ci sono procedure alternative per comunicazioni urgenti, copie accessibili dei contatti essenziali, esportazione e conservazione indipendente dei dati, ruoli di emergenza e modalità per riprendere il lavoro quando la piattaforma torna online. Non basta avere un piano scritto: deve essere testato senza dipendere proprio dai servizi che potrebbero essere indisponibili.
Il tema riguarda anche la struttura fisica dell’economia digitale. L’espansione dei data center usati da Microsoft e dagli altri hyperscaler è spesso discussa in termini di energia e capacità di calcolo; affidabilità, ridondanza e interconnessioni sono un’altra parte della stessa infrastruttura. Più servizi si appoggiano a piattaforme condivise, più diventa importante capire quali dipendenze siano comuni e quali alternative siano davvero indipendenti.
La crescita dei servizi cloud rende inoltre strategica la capacità di distribuire carichi e dati su più infrastrutture. L’espansione di IREN verso i data center AI e la corsa globale alle infrastrutture AI mostrano come capacità, energia e geografia stiano diventando componenti essenziali dei servizi digitali. La ridondanza non si ottiene solo acquistando più server: conta anche la separazione dei sistemi e la possibilità concreta di passare a un fornitore alternativo.
Il confronto con gli accordi multi-cloud va comunque fatto con precisione. Un secondo fornitore non garantisce continuità se identità, posta, backup o processi interni restano legati allo stesso punto di errore. Anche l’accesso a modelli e servizi da cloud differenti, come nel caso dell’anteprima di modelli OpenAI su Google Cloud, non equivale automaticamente a una strategia di disaster recovery: servono architetture e test specifici.
Microsoft 365 in sintesi
Microsoft 365 in sintesi
Cosa è confermato, cosa no
- Confermato: Microsoft ha segnalato un incidente che ha interessato più servizi Microsoft 365 e ha comunicato progressi nel recupero.
- Non indicato: il numero verificato di utenti colpiti e la root cause completa, che Microsoft ha promesso di documentare dopo la mitigazione.
- Da seguire: chiusura dell’incidente, rapporto post incidente e ripristino stabile di posta e funzioni collegate.
La lettura più grande
La nostra lettura, dichiarata come interpretazione editoriale, è che l’episodio renda visibile il costo operativo della concentrazione: una modifica di rete può influire su strumenti diversi quando condividono componenti e infrastrutture. Non è una prova che il cloud sia intrinsecamente inaffidabile, né dimostra che la ridondanza di Microsoft fosse insufficiente; per giudicare le cause e le misure correttive occorre attendere il rapporto tecnico.
I prossimi segnali sono la chiusura ufficiale dell’incidente, la spiegazione dettagliata della sequenza tecnica e le azioni di prevenzione annunciate da Microsoft. Per i clienti, il test più utile è verificare se le procedure di emergenza funzionano quando posta, collaborazione e accesso ai file dipendono contemporaneamente da un unico ecosistema.
Fonti
Stato dei servizi e aggiornamenti sul ripristino: Microsoft Service Health, consultato il 14 novembre 2026. Portata internazionale, ripresa e dipendenza dei servizi: Associated Press, 13 novembre 2026. Dichiarazioni Microsoft sulla causa tecnica e sul ripristino: Sky News, 13 novembre 2026.